16. November 2026
KI im Service-Postfach: Was ein kleines Modell auf deinem Rechner kann
Kann KI Service-Mails sortieren, ohne dass eine Mail das Haus verlässt? Mein Test mit kleinen Modellen auf normalen Rechnern, ohne Grafikkarte.
Dein Service-Postfach läuft über. Kündigungen, Rückbuchungen, Passwort-Fragen, Datenschutz-Anfragen, und dazwischen eine Mail, die man nicht übersehen darf. Jemand muss jede lesen, einordnen und beantworten.
Die naheliegende Frage: Kann eine KI das vorsortieren? Und zwar so, dass keine Kundenmail zu einem Online-Dienst im Ausland geschickt wird?
Ich habe das ausprobiert. Mit kleinen KI-Modellen, die auf einem ganz normalen Rechner laufen. Bewusst ohne Grafikkarte (GPU), das ist die teure Spezialhardware, die große Modelle normalerweise brauchen. Ich wollte wissen, was auf normalen Rechnern geht. Für alle, die gerade keine gute GPU haben oder keine kaufen wollen.
Gebaut habe ich den Test mit KI-Agenten. Alle Mails und alle Mitglieder darin sind erfunden. Die Plattform, für die sie geschrieben sind, ist ein Beispiel für eine Mitglieder-Plattform, mehr nicht. Echte Kundendaten kamen nicht vor.
Lesen: ein kleines Modell sortiert so gut wie zwei größere
Die erste Aufgabe: Mails lesen und elf Fragen dazu beantworten. Welches Anliegen? Wird eine Antwort erwartet? Du oder Sie? Welcher Betrag, welches Datum, welche Nummer? Ist es kritisch? Eilt es?
Ich habe 16 normale Mails getestet, also 176 Antworten, und danach 16 knifflige Mails mit je einer eingebauten Falle. Zum Beispiel drei Beträge in einer Mail, von denen nur einer gemeint ist, oder eine Notlage ohne ein einziges Alarmwort.
Verglichen habe ich drei Modelle. Die Größe eines Modells misst man in Parametern, das sind grob die einstellbaren Stellschrauben im Inneren. Mehr Milliarden heißt meist: größer, langsamer, teurer.
- d1-2B von Liquid AI (2 Milliarden Parameter) lief direkt auf meinem Rechner.
- Ministral 3 14B von Mistral (14 Milliarden) lief über eine Online-Schnittstelle.
- Mistral Small 4 (119 Milliarden) ebenfalls.
„Groß” sind die beiden Mistral-Modelle nur im Vergleich zu d1. In ihrer eigenen Modellreihe gehören sie zu den kleineren.
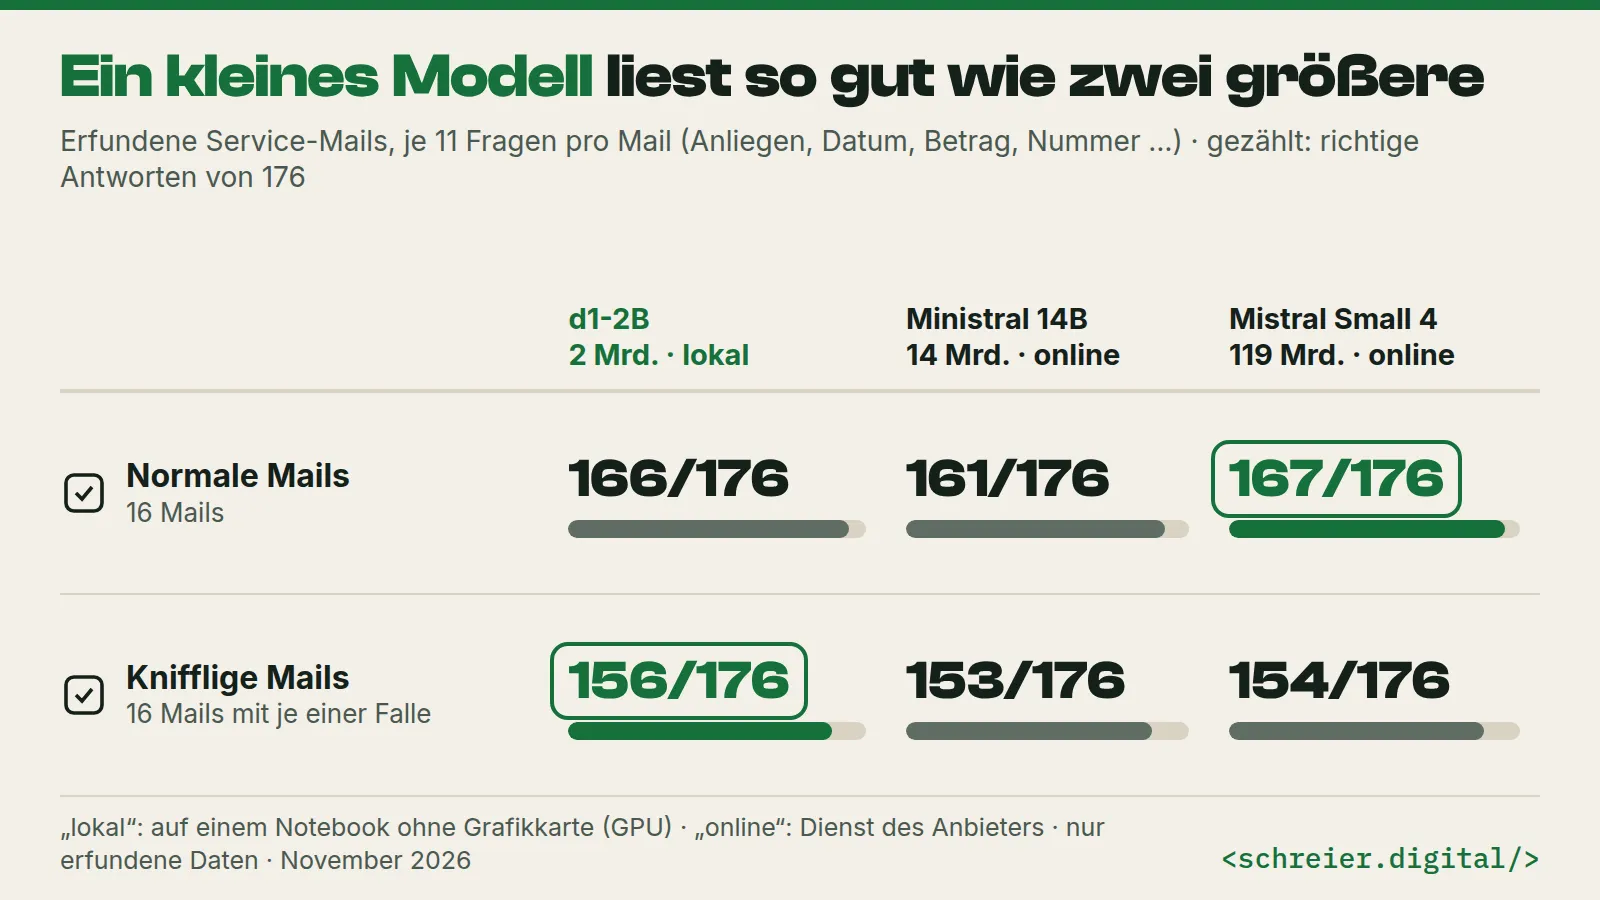
Ein kleines Modell auf dem eigenen Rechner liest so gut wie zwei größere Online-Modelle.
Bei den normalen Mails kam d1 auf 166 von 176 richtigen Antworten, Ministral auf 161 und Mistral Small 4 auf 167. Bei den kniffligen Mails verlieren alle drei zwischen 8 und 13 Antworten: d1 landet bei 156, Ministral bei 153, Small 4 bei 154.
Für das Einordnen dieser Mails brauchte es in meinem Test also kein großes Modell. Eine Mail mit allen elf Fragen dauerte 5 bis 22 Sekunden, bei rund 2 GB Arbeitsspeicher. Gemessen habe ich auf einem Notebook und auf einem kleinen Server mit 15-Watt-Prozessor.
Schreiben: hier reicht es nicht
Dann sollten drei kleine Modelle bis 2 Milliarden Parameter Antworten an die Mitglieder entwerfen: LFM3-1.7B, Qwen3.5-2B und Qwen3-1.7B. Brauchbar war keine. Sie erfanden Beträge, schrieben aus der falschen Perspektive oder nannten die Telefonnummer des Mitglieds als unsere Rückrufnummer.
Die zwei Mistral-Modelle schrieben sauber. Aber auch sie meldeten manchmal Aktionen als erledigt, die niemand ausgeführt hatte: „Deine Kündigung haben wir notiert”, obwohl nichts notiert war.
Deshalb setze ich die Antworten aus freigegebenen Textbausteinen zusammen. Beträge und Daten trägt ein klassisches Programm ein, also eines ohne KI, nicht das Modell. Und jede Entwurfsantwort geht an einen Menschen, bevor etwas rausgeht.
Bei Mails in einer Notlage oder mit Datenschutz-Forderung entscheidet das Modell nie allein, ob sie kritisch sind. Das Anliegen und feste Regeln legen es fest. Das Modell darf eine Mail nur hochstufen, nie herunter. Eine leise Mail einer einsamen Witwe stufte es auf die direkte Frage „Ist das kritisch?” in zwei von drei Varianten als unkritisch ein.
Handeln: drei Arten von Mails
Lesen und Schreiben sind das eine. Dazu kommt die Frage, ob das System aus einer Mail einen Vorschlag für eine Aktion machen darf, etwa eine Rückbuchung vorzubereiten. Dafür habe ich 16 neue, knifflige Testmails von einem eigenen KI-Agenten schreiben lassen, nachdem ich das Programm eingefroren hatte. In drei Gruppen:
- 7 Mails ohne Auftrag. Richtig ist: kein Vorschlag.
- 4 Mails mit unklarer Angabe. Richtig ist: nachfragen.
- 5 Mails mit klarem Auftrag. Richtig ist: ein Vorschlag mit allen Werten.
„Richtig behandelt” heißt genau das, bestenfalls 16 von 16.
d1-2B zusammen mit meinem Programm schaffte 7 von 7, 4 von 4 und 5 von 5, also 16 von 16. Bei 14 der 16 Mails bestand die Antwort komplett aus Textbausteinen. Eine Mail brauchte rund 15 Sekunden. Die Programm-Schritte selbst brauchen 0,2 Millisekunden, eine fünftausendstel Sekunde.
Die Mistral-Modelle bekamen dieselben Mails und durften die Funktionen selbst auslösen, mit dem heutigen Datum. Ministral kam auf 7 von 7, 1 von 4 und 2 von 5. Mistral Small 4 auf 7 von 7, 3 von 4 und 0 von 5. Es schlug bei keinem klaren Auftrag etwas vor. Eine unklare Mail folgte einer Hausregel, die nur mein Programm kannte.
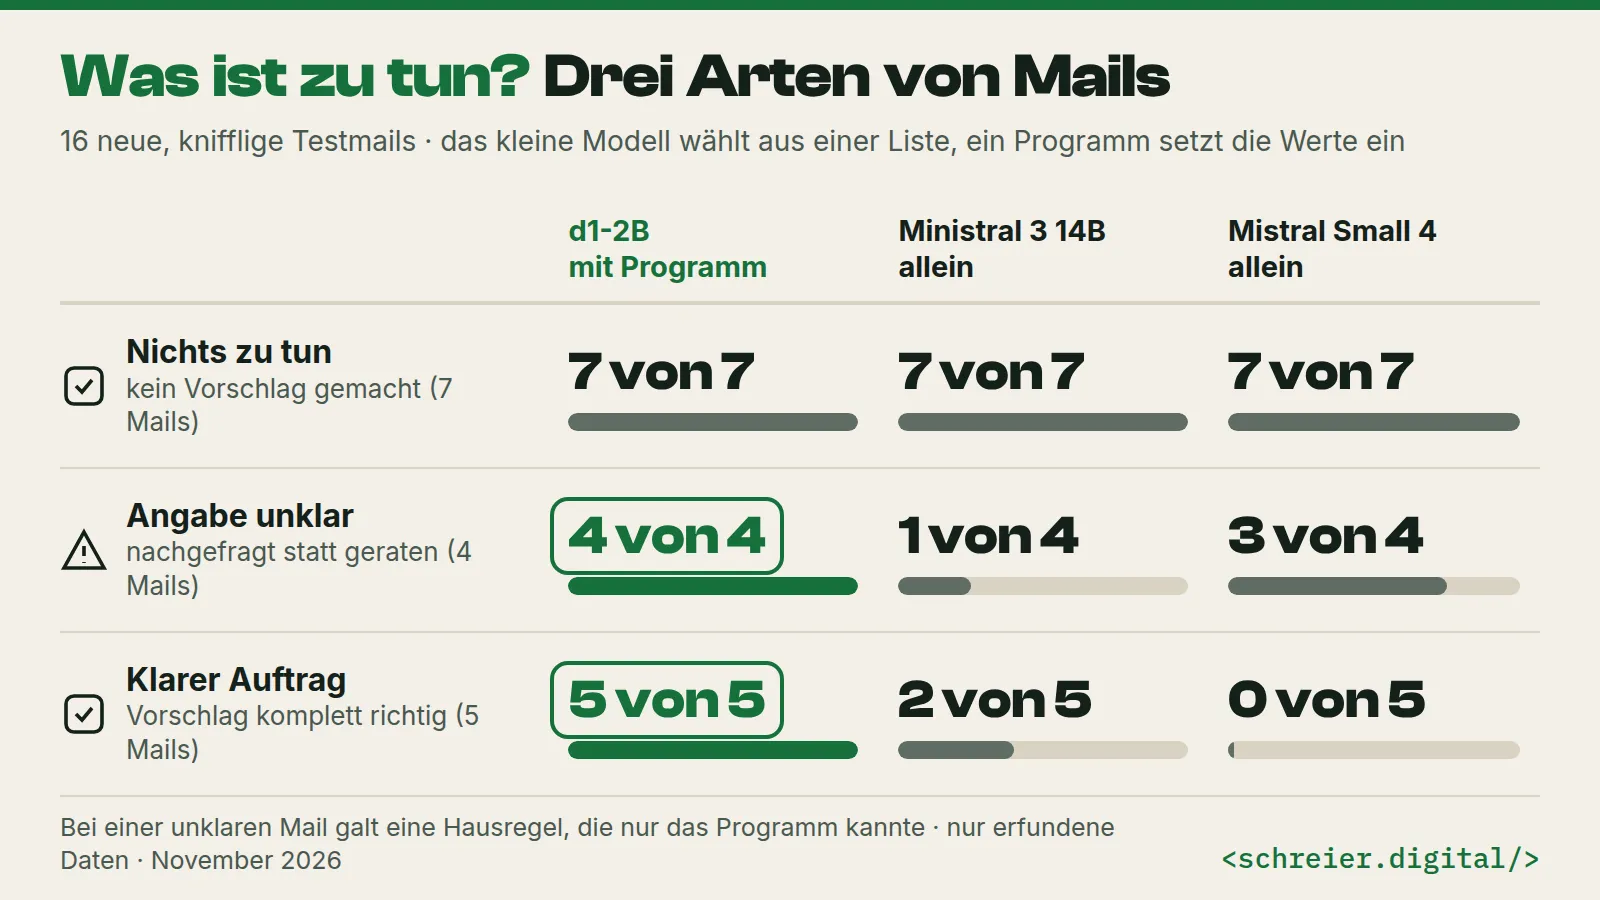
Nichts zu tun, unklar, klarer Auftrag: Was die Modelle daraus gemacht haben.
Nachgeprüft: der erste Versuch war schlechter
Mit meinen ersten kniffligen Testmails ordnete das Modell alles richtig ein, aber nur 1 von 5 Vorschlägen war komplett. Das Programm kannte „Ende nächsten Monats” und „vorgestern” nicht und las „vierundzwanzig Euro neunzig” als 24,00 €. Gefunden habe ich das, weil ich nicht nur gezählt, sondern die Vorschläge einzeln angesehen habe.
Dafür habe ich einen eigenen Programmteil gebaut. Danach waren es 4 von 5. Weil ich die Testmails dabei kannte, habe ich zur Kontrolle neue geschrieben: Dort waren es 5 von 5.
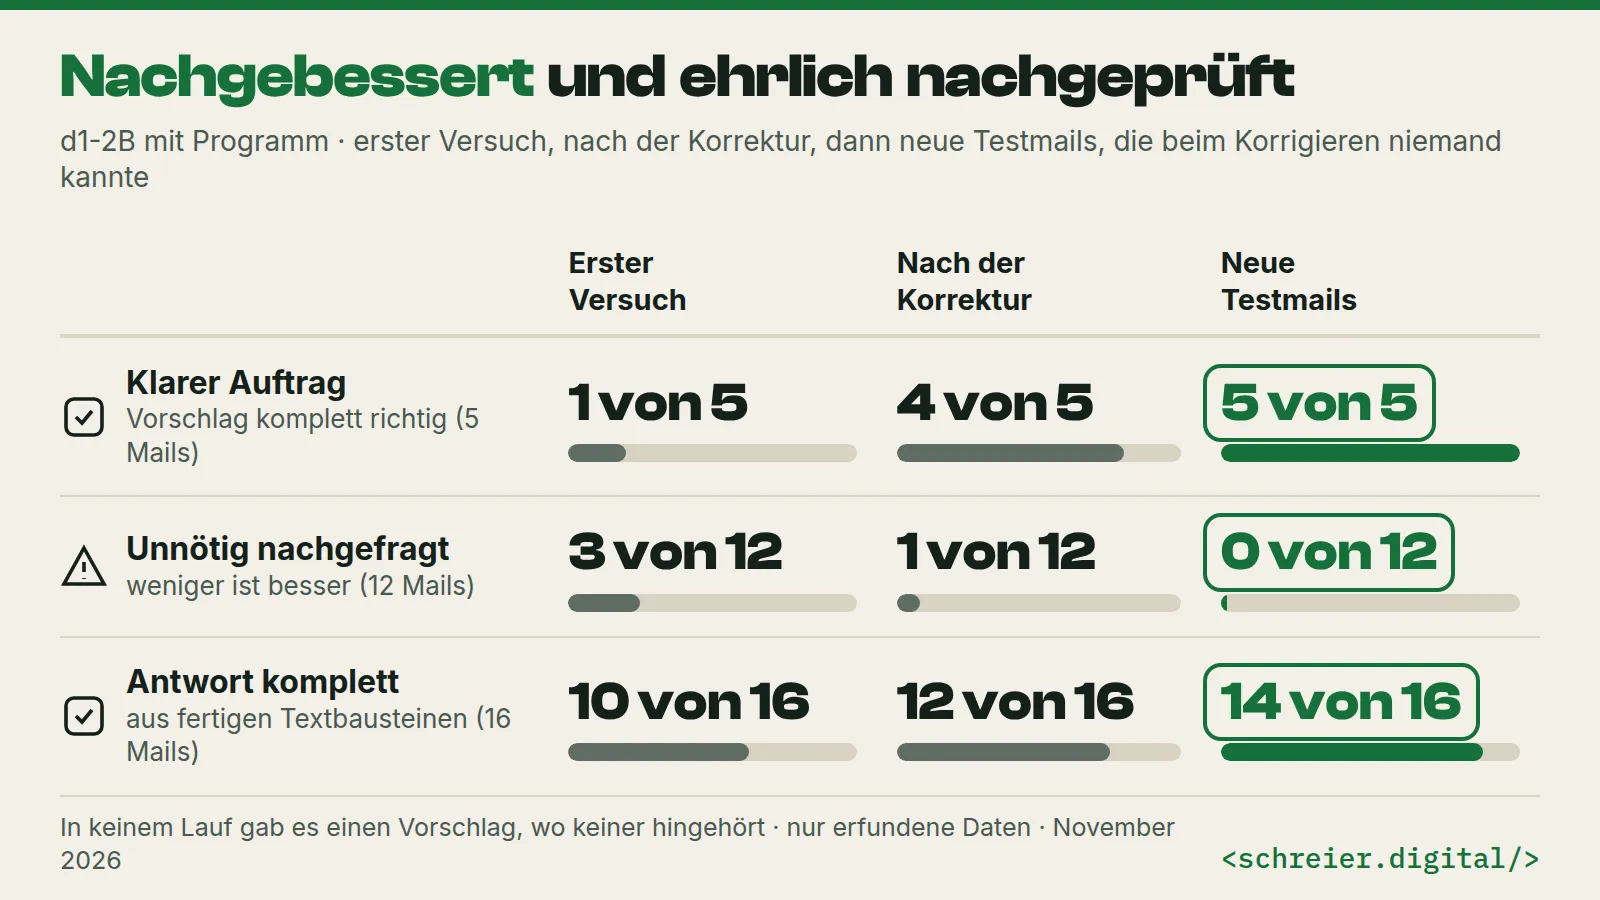
Nachgebessert und mit neuen Testmails nachgeprüft.
Liegt es am Modell oder an der Aufgabenteilung?
Um das zu klären, habe ich dieselben kleinen Modelle auf zwei Wegen laufen lassen: mit meinem Programm und allein. Richtig behandelt von 16 Mails:
- LFM3-1.7B: 15 mit Programm, 8 allein
- Qwen3.5-2B: 14 mit Programm, 10 allein
- Qwen3-1.7B: 13 mit Programm, 11 allein
Mit Programm-Hilfe wurde jedes getestete Modell besser.
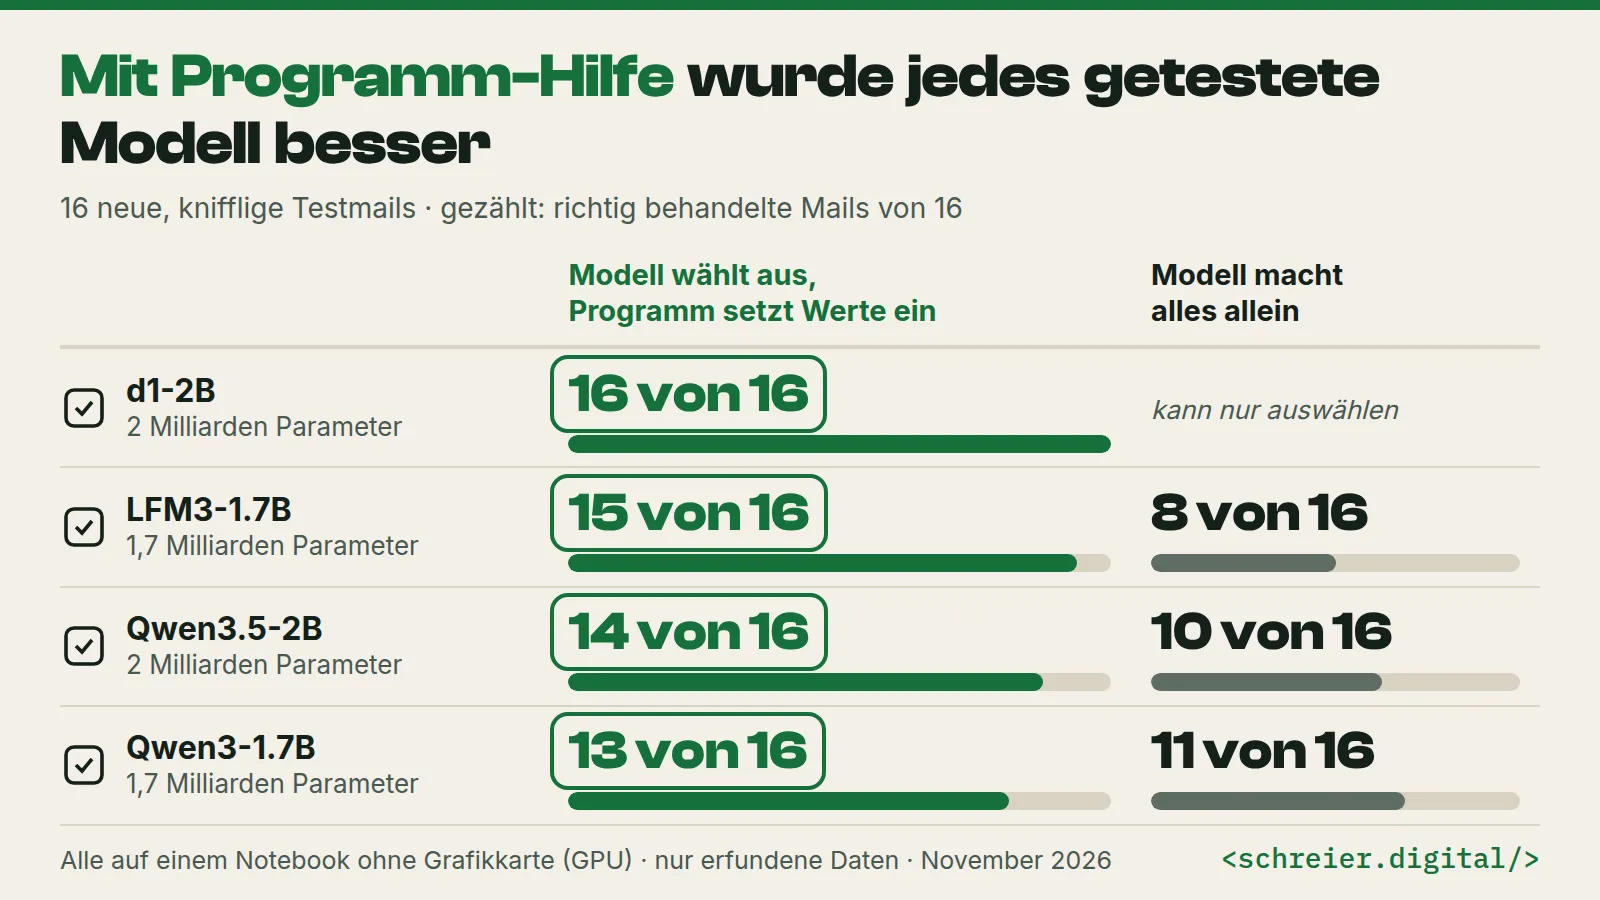
Mit Programm-Hilfe wurde jedes getestete Modell besser.
In einer Mail standen zwei Beträge. d1 meldete Unsicherheit, das System fragte beim Mitglied nach. LFM3 war sich sicher und nahm den falschen. Ein Modell, das seine Unsicherheit meldet, ist im Service mehr wert als eines, das immer eine Antwort hat.
Was das für deinen Kundenservice heißt
Gib ein Postfach nicht auf einmal an eine KI. Geh in Stufen vor:
- Probelauf. Das Modell liest mit und sortiert. Es löst nichts aus. Du vergleichst seine Einordnung mit der deines Teams.
- Vorschlag. Das System bereitet Antworten und Aktionen vor. Dein Team sieht sie, ändert sie oder verwirft sie.
- Klick. Ein Mensch gibt frei, erst dann geht etwas raus.
So nimmt die KI dem Team die Standard-Mails ab und gibt Zeit zurück für die Fälle, die einen Menschen brauchen. Nichts geht ungeprüft raus. Und weil das Modell auf deinem eigenen Server läuft, verlässt keine Kundenmail das Haus. Für den Datenschutz ist das ein einfacher Punkt.
Das hier ist die Kurzfassung. Die ausführliche Messung mit allen Zahlen steht in meinem LinkedIn-Artikel zu Teil 1. Teil 2 zum Handeln folgt dort in den nächsten Tagen.
Die Läufe der beiden Mistral-Modelle kosteten zusammen unter 60 Cent.
Was der Test nicht zeigt
Die Mails sind erfunden und es sind wenige. 32 plus 16 Mails sind keine Statistik, sie geben einen ersten Eindruck. Die zwei Mistral-Modelle liefen über die Online-Schnittstelle, nicht lokal. Große Modelle wie Claude oder GPT habe ich nicht getestet, deshalb sage ich dazu nichts. Aussagen gelten nur für die getesteten Modelle und diese Mails.
Ob dein Postfach so aussieht wie mein Test, zeigt erst ein Probelauf mit deinen eigenen Mails.

Diplom-Informatiker · 25 Jahre Entwicklung · LinkedIn
Weitere Artikel
10. November 2026
Was die KI im Vorstellungsgespräch macht und was nicht
Eine KI führt ein Übungsgespräch mit Azubis. Was sie dabei übernimmt, was sie bewusst nicht entscheidet und warum das so gebaut ist.
3. November 2026
Wie fühlt sich ein Gespräch mit einem KI-Interviewer an?
Ein Durchlauf in der Übungs-App vorstell.bar: vom Wunschberuf über die ersten Fragen bis zum Feedback. Am Beispiel Kfz-Mechatroniker.
